Работодатели сейчас всё активнее думают, как заменить часть работы сотрудников нейросетями.
Мне кажется, самим людям тоже стоит подумать в обратную сторону: как не оставить весь накопленный с AI опыт внутри чужих сервисов.
Потому что полезные знания очень быстро расползаются по ChatGPT, Claude, Grok, Gemini, DeepSeek, Codex, IDE-агентам и десяткам отдельных чатов.
Где-то ты несколько часов разбирал архитектуру. Где-то настраивал сервер. Где-то искал рабочую схему деплоя. Где-то доводил до ума процесс ревью. Где-то просто в ходе длинного разговора выработал хороший рабочий подход.
А через полгода попробуй всё это найди.
Причём часть систем уже постепенно двигается в эту сторону. Например, в ChatGPT есть Projects: можно собрать в одном проекте чаты, файлы и инструкции по конкретной теме, а потом попросить ChatGPT обобщить накопившийся материал и оформить результат в Markdown.
То есть даже внутри самого ChatGPT уже можно сделать что-то вроде:
Remote Development
  ├─ настройка Ubuntu
  ├─ VSCode Remote
  ├─ JetBrains
  ├─ Cloudflare Access
  └─ итог → remote-dev.md
Но я бы всё равно не оставлял единственную копию там.
И тут совсем необязательно сразу городить RAG и отдельную AI-платформу.
Можно начать вообще без скриптов.
Самая простая схема:
чат → Markdown → своё хранилище
Например, создать закрытый репозиторий на GitHub:
my-skills
И после каждого действительно полезного разговора просить нейросеть не просто оставить всё в истории, а оформить результат в отдельный .md.
Например:
Оформи результат этого разговора как универсальную инструкцию в Markdown и сохрани в my-skills.
Если такая инструкция уже есть:
Обнови существующий файл новыми знаниями из этого разговора, без повторов.
Структура может быть совсем простой:
my-skills/

development/
  laravel-deploy.md
  github-pr-review.md
  remote-dev.md

infrastructure/
  cloudflare-access.md
  nginx-reverse-proxy.md
  ubuntu-server-setup.md

projects/
  project-a/
  project-b/
У многих AI-инструментов уже есть работа с GitHub, поэтому для базового варианта даже отдельную автоматизацию писать не обязательно.
GitHub при этом тоже не принципиален.
Можно сделать обычную папку AI-Skills на компьютере и держать копию в Яндекс Диске, Облаке Mail.ru, на своём сервере или в любом другом хранилище.
Причём сохранять лучше не пересказ чата, а уже нормальную рабочую инструкцию:
Тогда через какое-то время получается уже не архив переписок, а собственная библиотека рабочих решений.
Сейчас активно развиваются OpenClaw, Claude Code, Codex и другие агентские системы, которые умеют работать не просто с одним промптом, а с постоянными инструкциями, файлами проекта, skills и дополнительным контекстом.
То есть папка my-skills постепенно может стать не просто архивом заметок, а реальным рабочим слоем поверх разных моделей.
Например:
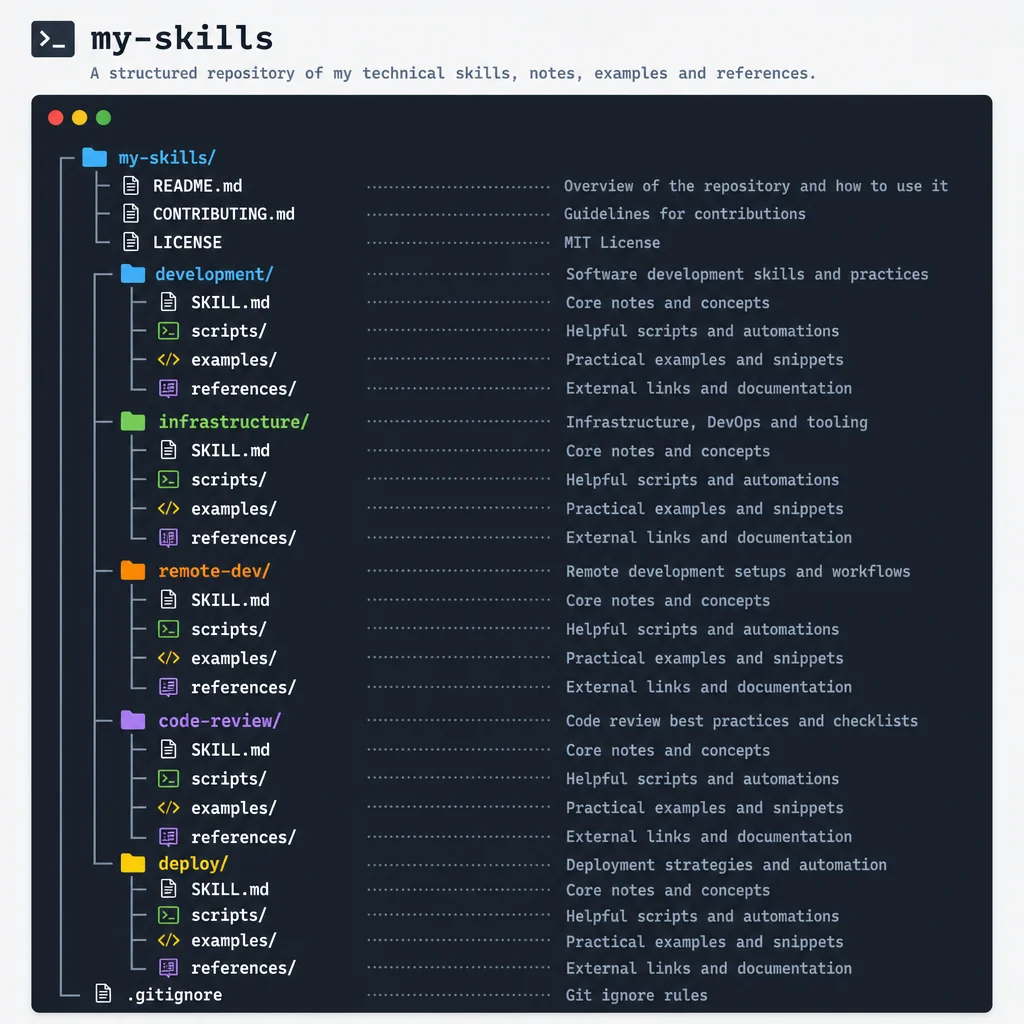
my-skills/

remote-dev/
  SKILL.md
  scripts/
  examples/

code-review/
  SKILL.md

deploy/
  SKILL.md
  scripts/
  references/
Где SKILL.md — основная инструкция, а рядом лежат готовые скрипты, примеры конфигов и дополнительные материалы.
И тогда сегодня этот набор использует один агент, завтра другой.
Сегодня ChatGPT.
Завтра Claude Code.
Потом Codex, OpenClaw или какая-нибудь локальная модель.
А твои инструкции при этом остаются у тебя.
Не у OpenAI.
Не у Anthropic.
Не у Google.
Не внутри одного конкретного чата.
А в собственной базе, которую можно подключать к разным инструментам.
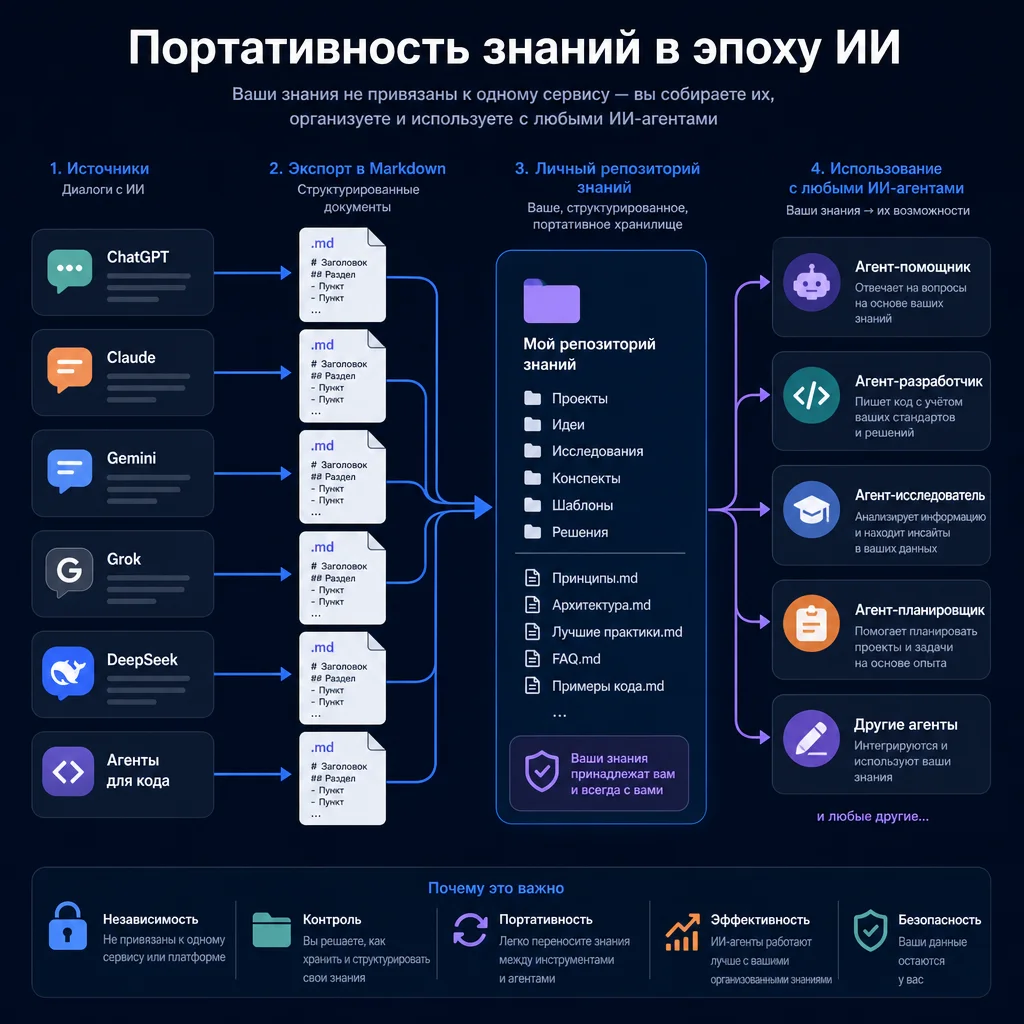
По сути, со временем получается примерно такая схема:
AI-чаты
   ↓
сборка по темам
   ↓
полезные результаты
   ↓
Markdown
   ↓
собственная база знаний
   ↓
универсальные инструкции / skills
   ↓
любые AI-агенты
По-моему, это одна из вещей, о которых сейчас довольно мало говорят.
Все сравнивают модели, бенчмарки и подписки.
Но модели будут постоянно меняться. Сегодня одна лучше в коде, через полгода другая. Один сервис подорожал — перешёл на другой. Появился хороший локальный вариант — часть работы уехала туда.
А вот собственные рабочие инструкции, решения и накопленный за годы опыт лучше держать отдельно от всего этого.